
Startup Portfolio
数学的なブレークスルーによりデータベースの演算コストを95%削減する"Feldera"がSeedとSeries Aで合計$21.5Mを調達
Felderaは、SeedとSeries Aで合計$21.5Mを調達しました。内訳は、Inovia Capitalがリードし、Costanoa VenturesとBattery Venturesが参加した$15.4MのSeries Aと、Costanoa Venturesがリードし、DatabricksとAnyscaleの共同創業者であるIon Stoicaが参加した$6.1MのSeedです。
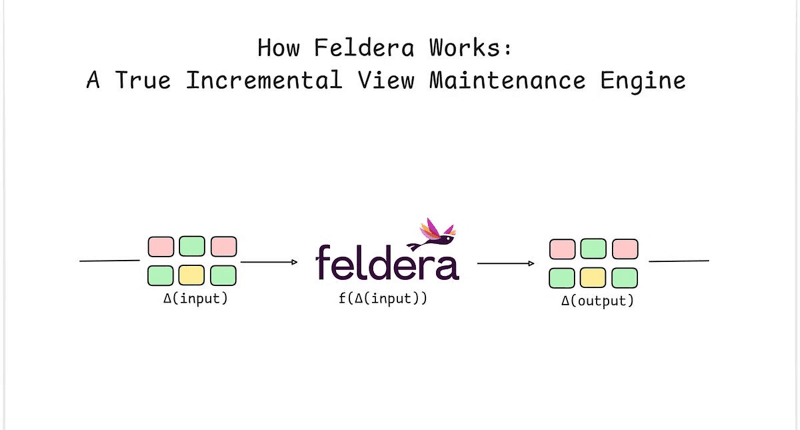
企業向けインクリメンタル・ビュー・メンテナンス・エンジンを提供するFelderaは、AIエージェントとそれを利用する人々の双方に向けて、膨大なデータセットから得られる回答を常に最新の状態に保つための処理を、大幅に高速化し、コスト効率を高めるエンジンを開発しています。
現在、企業はかつてないほど大量のデータを保有していますが、それらのデータをAIエージェントのための信頼できる基盤へと変換するには、依然として多額のコストと時間がかかります。従来型の分析プラットフォームでは、基礎となるデータのごく一部しか変更されていない場合でも、クエリが実行されるたびにデータベース全体を繰り返しスキャンする、総当たり的な処理に依存することが少なくありません。
こうした計算処理の重複によって、AI対応プロダクトには難しいトレードオフが生じます。急増するコンピューティングコストを負担するか、古く表層的なデータで妥協し、AIのパフォーマンスを制限するとともに、業務上の意思決定を遅らせるかという選択です。
Felderaは、インクリメンタル・ビュー・メンテナンスという技術によって、このボトルネックを解消します。この技術は、企業の膨大なデータベース全体にわたって、クエリ結果を継続的に最新の状態に維持します。基盤となる理論であるDBSP(Database Stream Processing)により、複雑なSQLクエリを、新たに変更されたデータだけを処理するインクリメンタルプログラムへ自動的に変換し、データベース全体を繰り返しスキャンする無駄を排除します。
このプラットフォームは、大規模なアーキテクチャ変更を必要とせず、既存のデータレイクと直接統合できます。Felderaによると、これによってコンピューティングコストを95%以上削減できるほか、従来は数時間を要していた分析パイプラインを1秒未満で更新できるようになります。
その結果、変更されていないデータに対してクラウドのコンピューティングリソースを繰り返し消費することなく、AIエージェントが正確な企業内コンテキストへ継続的かつ低遅延でアクセスできるようになります。Felderaによると、顧客はすでにリアルタイムの不正検知、大規模物流オペレーション、AIエージェント向けのきめ細かな権限制御などのユースケースで、この技術を本番環境に導入しています。
主な機能は以下の通りです。
- ユニバーサルSQLインクリメンタル化:複雑なSQLプログラムを、全体の再計算に戻ることなくインクリメンタルプログラムへ変換します。
- シームレスな統合:カスタムエンジニアリングや壊れやすいストリーミングコードを必要とせず、既存の企業向けデータウェアハウス、データレイク、データパイプラインへ直接接続できます。
- 書き換え不要:企業はコードを変更することなく既存のSQLワークロードをFelderaへ移行でき、数カ月に及ぶ可能性のある移行作業を不要にできます。
- ハードウェアを大幅に削減:Felderaによると、顧客はインフラコストを平均10倍削減しており、一部のワークロードでは100倍を超えるコスト削減を実現しています。
- エンタープライズ規模をノートPCの手軽さで実現:1秒あたり数百万件のレコードを処理し、従来はクラスターが必要だったワークロードを1台のノートPC上で実行できるようにします。
- 数学的に保証された正確性:基盤となるDBSP理論により、SQLの複雑さにかかわらず、Felderaの結果が対応するデータウェアハウスで生成される結果と一致することを形式的に保証します。
FelderaのCEO兼共同創業者Lalith Sureshは、「従来の手法を使って、急速に変化する膨大な量のデータに基づきタイムリーな意思決定を行うには、非常に大きなコンピューティングリソースが必要です。AIエージェントの性能は、アクセスできるデータの品質以上にはなりません。そのため、計算コストが高すぎるためにデータが古くなれば、企業は常に間違った結果を出すAIエージェントにトークンを浪費することになります」と述べています。
Felderaは2023年、VMwareの元研究者であるLalith Suresh、Leonid Ryzhyk、Mihai Budiu、Ben Pfaff、Gerd Zellwegerの5人によって設立されました。チームはこれまでに、データベースシステム、分散コンピューティング、オペレーティングシステムにまたがる200本以上の研究論文を発表しています。
チームの研究は、繰り返し発生していたある問題を出発点としています。エンジニアがインクリメンタルなデータ処理を行うために、壊れやすく場当たり的なソリューションに依存していたという問題です。VMware Researchで研究者たちは、この問題を数学的な基礎から解決することに取り組み、その成果としてインクリメンタルSQL計算のための受賞歴を持つフレームワークであるDBSPが誕生しました。
Felderaは、この研究成果を本番環境に導入し、高度なインクリメンタル計算を企業のエンジニアリングチームが利用できるようにするために設立されました。創業チームはStanford、Carnegie Mellon、ETH Zurich、UNSW、TU Berlinなどでの学術・技術的バックグラウンドに加え、大規模システムの設計における数十年の経験を有しています。
その結果、数十年にわたるデータベース研究を基盤とした企業向けエンジンが誕生し、これまで実現が困難だったインクリメンタル計算機能を、現代のデータインフラストラクチャで利用できるようになりました。
Inovia CapitalのPartnerであるTaha Mubashirは、「Felderaのチームは、50年来のデータベースにおける根本的な問題を厳密な数学的証明によって解決しました。企業がリアルタイムAIへの取り組みを拡大するにつれて、従来型のデータ処理に伴うコストと遅延は持続不可能になります。Felderaは、企業が継続的かつ複雑な分析をわずかなコストで実行するための基盤となるコンピューティングレイヤーを提供します」と述べています。
関連ニュース





Feldera に興味がありますか?
最新ニュース

企業のAIトランスフォーメーションを支えるトラストレイヤーを構築する"Cyera"がSeries Gの追加資金として$400Mを調達
2026/09/23
世界中の臨床医向けAI Care Partnerを提供する"Heidi"がSeries Cで$100Mを調達し評価額は$900Mに拡大
2026/09/23
パリ発でライフサイエンス業務向けのナレッジ駆動型オートメーションを構築する"Biolevate"がSeries Aで€30Mを調達
2026/09/23
英国でMixed Realityのアバターコンサートを制作する"Unit1 Studio"がSeries Aで£20Mを調達
2026/09/23
ベルギー発で採用エージェンシー向けのAIネイティブなATSとCRMプラットフォームを提供する"Spott"がSeries Aで$21Mを調達
2026/09/23